۱۹۹۶، ۱۹۹۹، ۲۰۲۴. سه سال، سه حوزهی کاملاً متفاوت: یه موشک فضایی اروپایی، یه فضاپیمای ناسا، و یه بهروزرسانی امنیتی که میلیون ها کامپیوتر ویندوزی رو از کار انداخت. اگه فقط تیتر خبرها رو بخونید، هر سه شبیه «یه اشتباه احمقانهی برنامهنویس» بهنظر میرسن. اما وقتی سراغ گزارشهای رسمی تحقیق میرید، تصویر عوض میشه: تو هر سه مورد، چیزی که خراب کرد قبلاً درست کار کرده بود یا نسبت به مشخصات خودش درست بود، و چند لایهی بازبینی که باید جلوش رو میگرفتن، نگرفتن.
بیایید سه داستان رو بر اساس گزارشهای اصلی مرور کنیم و بعد ببینیم چه الگویی بینشون هست.
۱. آریان ۵: کدی که برای موشک دیگهای نوشته شده بود (۱۹۹۶)
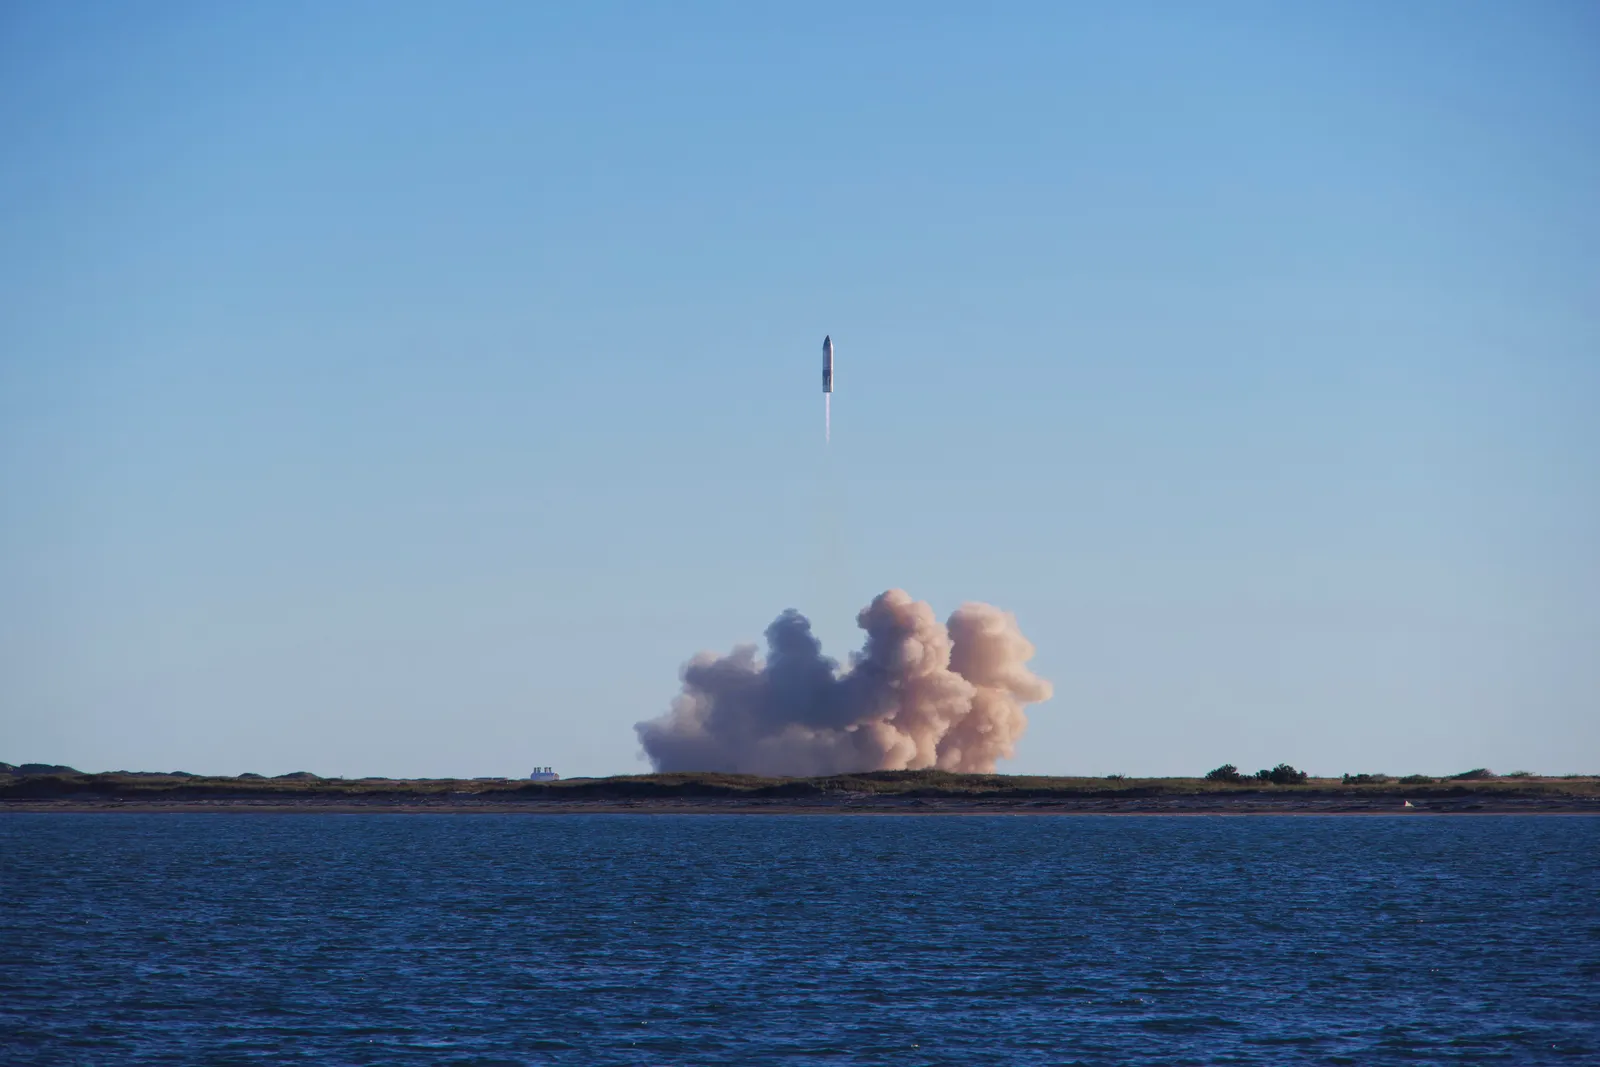
۴ ژوئن ۱۹۹۶، اولین پرواز موشک آریان ۵ از پایگاه کورو در گویان فرانسه. حدود ۳۷ ثانیه بعد از روشن شدن موتور اصلی (یعنی ۳۰ ثانیه بعد از جدا شدن از زمین)، موشک اطلاعات هدایت و وضعیتش رو کامل از دست داد و از هم پاشید. روی موشک چهار ماهواره برای مطالعهی میدان مغناطیسی زمین بود.
خسارت حدود ۳۷۰ میلیون دلار برآورد شد؛ بعضی منابع با احتساب کل موشک و محموله تا حدود ۵۰۰ میلیون هم میگن. تو بعضی منابع فارسی عدد «۸ میلیارد دلار» برای این خسارت دیده میشه که دقیق نیست. رقمی نزدیک به ۷ میلیارد دلار مربوط به ده سال هزینهی توسعهی کل برنامهی آریان ۵ بوده، نه خسارت این پرتاب.
چی اتفاق افتاد؟
سیستم مرجع (SRI)، که جهت و حرکت موشک رو میسنجه، یه عدد ۶۴ بیتی اعشاری (مربوط به سرعت افقی موشک) رو به عدد صحیح ۱۶ بیتی تبدیل میکرد. بزرگترین عددی که تو این قالب جا میشه ۳۲٬۷۶۷ه. تو پرواز آریان ۵ مقدار از این حد بیشتر شد، تبدیل شکست خورد و یه استثنای نرمافزاری پیش اومد.
چرا این مشکل قبلاً پیش نیومده بود؟ چون این بخش از کد از آریان ۴ به ارث رسیده بود؛ موشکی که مسیر پروازش مقدارهای کوچیکتری تولید میکرد. آریان ۵ تو همون ثانیههای اول، مقدارهای خیلی بزرگتری ساخت. طبق گزارش هیئت تحقیق، اون تابع اصلاً برای پرواز آریان ۵ لازم نبود: کارش تنظیم پلتفرم قبل از پرتاب بود (و برای قابلیت توقف و راهاندازی مجدد شمارش معکوس تو آریان ۴)، ولی بعد از پرتاب هم روشن مونده بود.
نکتهی جالب اینجاست که تیم توسعه هفت تبدیل پرریسک از این نوع رو شناسایی کرده بود. برای بعضیهاشون، از جمله همین یکی، محافظ نذاشته بودن، چون بر اساس مسیر آریان ۴ نتیجه گرفته بودن که سرریز «از نظر فیزیکی» ممکن نیست. یعنی فرض درست بود، اما برای موشک قبلی.
زنجیرهی خرابی
وقتی استثنا رخ داد، طبق طراحی، واحد SRI خاموش شد و یه الگوی بیتی تشخیصی روی گذرگاه داده نوشت. کامپیوتر پرواز اون رو بهجای پیام خطا، دادهی واقعی هدایت فرض کرد و نازل موتورها و بوسترها رو تا آخر منحرف کرد. موشک بدون اطلاعات درست پرواز میکرد، از هم پاشید و سیستم خودتخریب هم فعال شد.
یه نکته دربارهی آزمایشها: بعد از حادثه، شبیهسازی با دادهی واقعی مسیر پرواز، دقیقاً همین خرابی رو باز تولید کرد. یعنی قبل از پرتاب، این واحد با شرایط واقعی آریان ۵ آزمایش نشده بود. هیئت تحقیق، به ریاست ژاک-لویی لیونز، یه اصل کلی هم تو گزارشش ثبت کرد: نرمافزار تا وقتی با بهترین روشهای پذیرفتهشده درستیش نشون داده نشده، باید معیوب فرض بشه.
۲. مارس کلایمت اوربیتر: دو سیستم واحد که با هم حرف نمیزدن (۱۹۹۹)
۲۳ سپتامبر ۱۹۹۹، فضاپیمای حدود ۱۲۵ میلیون دلاری ناسا بعد از حدود ۹ ماه سفر، آمادهی ورود به مدار مریخ بود. سیگنال آخرش ساعت ۰۹:۰۴:۵۲ به وقت UTC دیده شد، همون موقع که وارد پشت مریخ شد، و بعد از اون هیچوقت برنگشت.
علت اصلی طبق گزارش رسمی
هیئت تحقیق ناسا (گزارش فاز اول، نوامبر ۱۹۹۹) علت اصلی رو اینطور ثبت کرد: استفاده نشدن از واحدهای متریک در کد یه فایل نرمافزار زمینی به اسم Small Forces. این نرمافزار، که لاکهید مارتین ساخته بود، دادهی نیروی پیشرانهای فضاپیما رو با واحد انگلیسی (پوند-نیرو-ثانیه) تولید میکرد، در حالی که مشخصات رابط، واحد متریک (نیوتن-ثانیه) رو الزام کرده بود. تیم محاسبهی مسیر هم، همونطور که مشخصات میگفت، فرض کرد داده متریکه.
نتیجه این شد که خطاهای کوچیک مسیر، ماهها روی هم جمع شد و فضاپیما خیلی پایینتر از مسیر برنامهریزیشده به مریخ رسید. گزارشها از ارتفاع حدود ۵۷ کیلومتر میگن، جایی که جو مریخ فضاپیما رو نابود کرد یا از مسیر خارجش کرد.
روایت «یه اشتباه سادهی واحد» ناقصه
تیتر معروف این ماجرا اینه که «ناسا و پیمانکارش واحدها رو قاطی کردن». ولی هیئت تحقیق چیز دقیقتری نوشت: تو پروژههای فضایی اشتباه همیشه پیش میاد، و معمولاً فرایندهای کافی وجود داره که قبل از بحرانی شدن، اشتباه رو بگیره. اینجا اون فرایندها خطا رو نگرفتن.
از عوامل کمکی که هیئت ثبت کرد:
تست انتهابهانتها برای نرمافزار زمینی انجام نشده بود
تیم ناوبری با طراحی فضاپیما آشنایی کافی نداشت
کادر ناوبری کم بود و آموزش کافی ندیده بود
فرایند مهندسی سیستم ناکافی بود
ارتباط بین بخشهای مختلف پروژه ضعیف بود
یعنی یه اشتباه واحد، لازم بود از چند لایهی کنترل رد بشه تا فضاپیما رو نابود کنه، و رد شد.
۳. کراوداسترایک: یه فایل پیکربندی، هشت و نیم میلیون دستگاه (۲۰۲۴)
۱۹ ژوئیه ۲۰۲۴، ساعت ۰۴:۰۹ به وقت UTC، شرکت CrowdStrike یه بهروزرسانی پیکربندی (به اسم Channel File 291) برای نرمافزار امنیتی Falcon روی ویندوز پخش کرد. ساعت ۰۵:۲۷ همون فایل برگردونده شد؛ یعنی فقط ۷۸ دقیقه. اما دستگاههایی که تو این بازه فایل رو گرفته بودن، با صفحهی آبی خطا کرش کردن و دوباره بالا نیومدن. مایکروسافت تعداد دستگاههای ویندوزی تحت تاثیر رو حدود ۸.۵ میلیون برآورد کرد، یعنی کمتر از یک درصد از کل ویندوزها. مک و لینوکس تحت تاثیر نبودن.
بازیابی عمدتاً دستی بود: دستگاه رو تو Safe Mode بالا بیارن، فایل معیوب رو پاک کنن و ریستارت کنن، گاهی دستگاهبهدستگاه. فرودگاهها، بیمارستانها و بانکها هم به همین دلیل مختل شدن.
علت فنی طبق گزارش خود CrowdStrike
تو گزارش علتیابی که ۶ اوت ۲۰۲۴ منتشر شد، ماجرا اینطور توضیح داده شده: قالب جدیدی که اوایل ۲۰۲۴ اضافه شده بود، ۲۱ فیلد ورودی تعریف میکرد، ولی کدی که مفسر محتوا رو صدا میزد فقط ۲۰ مقدار میداد. مفسر هم فقط ۲۰ مقدار انتظار داشت. وقتی فایل ۱۹ ژوئیه فیلد ۲۱ام رو با یه مقدار مشخص (نه wildcard) استفاده کرد، مفسر مجبور شد خونهی بیستویکم یه آرایهی بیستتایی رو بخونه. این یه خوندن خارج از محدودهی حافظه بود، اونم داخل یه درایور در سطح کرنل ویندوز، جایی که ویندوز نمیتونه خطا رو مهار کنه.
بر اساس تحلیلهای گزارش، نمونههای قبلی همین فایل، فیلد ۲۱ام رو با wildcard داشتن و هیچوقت اون خونهی خارج از آرایه رو نخوندن. برای همین، ماهها پیش بدون مشکل کار کرده بودن.
چرا بازبینیها نگرفتنش؟
دو لایهی کنترل شکست خورد. اول، فایل بهخاطر باگ تو نرمافزار اعتبارسنجی محتوا، از بررسی رد شده بود. دوم، تحلیلها به نبود پخش مرحلهای (staged rollout) برای این نوع بهروزرسانی اشاره میکنن؛ فایل یکدفعه برای همه رفت، بهجای اینکه اول روی تعداد کمی دستگاه امتحان بشه. بعد از حادثه، CrowdStrike اعتبارسنجی بیشتر و بررسی مرز آرایه (bounds checking) رو اضافه کرد.
الگوی مشترک
اگه این سه داستان رو کنار هم بذارید، سه چیز تکرار میشه.
۱. «قبلاً جواب داده بود». تو آریان ۵، کد از موشک قبلی اومده بود. تو مارس کلایمت اوربیتر، همه فرض میکردن داده متریکه چون مشخصات همین رو میگفت. تو کراوداسترایک، نمونههای قبلی فایل بدون مشکل کار کرده بودن. هر بار، یه فرض قدیمی بدون بازبینی به شرایط جدید منتقل شد.
۲. هر لایهی کنترل، یه سوراخ داشت. آریان ۵: واحد با دادهی واقعی مسیر آزمایش نشده بود. مارس کلایمت اوربیتر: تست انتهابهانتها انجام نشده بود و تیم ناوبری کمنیرو بود. کراوداسترایک: اعتبارسنج باگ داشت و پخش مرحلهای وجود نداشت. هر لایه، شاید فرض میکرد لایهی دیگه کنترل رو انجام داده.
۳. اندازهی خرابی با اندازهی اشتباه متناسب نبود. یه تبدیل نوع، یه واحد اندازهگیری، یه فیلد اضافه. اشتباههایی که تو کد چند خط هم نمیشن، ولی چون تو جای حساس (هدایت موشک، مسیر فضاپیما، کرنل سیستمعامل) یا با پخش گسترده (همهی دستگاهها یکدفعه) اتفاق افتادن، نتیجهشون فاجعهبار بود.
همین الگو رو تو پست «کد تمیز یا تحویل سریع؟ ۴۴۰ میلیون دلار در ۴۵ دقیقه» هم دیدیم: کد قدیمی که فکر میکردن مرده، یه فلگ دوباره استفاده شده، و سرور هشتمی که آپدیت نشد.
چه درسهایی از این ماجراها گرفته میشه؟
تحلیلهای فنی این رویدادها چند توصیهی تکرارشونده دارن:
کد وارداتی رو مثل کد جدید بررسی کنید. وقتی کدی به محیط یا شرایط تازهای منتقل میشه (مثل آریان ۴ به آریان ۵)، فرضهاش باید دوباره اعتبارسنجی بشه، نه فقط اجرا.
قرارداد بین سیستمها رو قابلتست کنید. واحدها و قالب دادهها باید تو تستهای انتهابهانتها واقعاً چک بشن، نه فقط تو مستندات بیان.
تو مرزها اعتبارسنجی کنید. بررسی اندازهی ورودی و محدودهی آرایهها (مثل کاری که بعد از حادثه تو کراوداسترایک اضافه شد) سادهست، ولی یه کلاس کامل خطا رو میبنده.
تغییرات پرریسک رو مرحلهای پخش کنید. اگه فایل ۲۹۱ اول روی چند صد دستگاه امتحان میشد، خرابی قبل از گسترش شناسایی میشد.
بازبینی باید کل سیستم رو ببینه. اینکه هر بخش با مشخصات خودش سازگاره کافی نیست؛ کل زنجیره باید با شرایط واقعی امتحان بشه.
حرف آخر
این سه داستان، داستان آدمهای بیدقت نیستن. بهنظر میرسه داستان سیستمهاییان که هر لایهشون فرض میکرد لایهی دیگه کنترل رو انجام داده. اشتباهها کوچیک بودن؛ فاجعه از اینجا اومد که هیچکس اون اشتباه رو، تو شرایط واقعی، آخرینبار ندید.
دفعهی بعد که خبر یه باگ میلیوندلاری شنیدید، به جای «کدوم برنامهنویس اشتباه کرد؟»، بپرسید: «چه لایههایی باید جلوش رو میگرفتن، و چرا نگرفتن؟». معمولاً جواب این سوال، خیلی آموزندهتر از اسم کسیه که کد رو نوشته.